Come scrapare qualsiasi sito con Python nel 2026
Un workflow /scrape generale: fetch statico di default, sali a rendering JS e proxy premium solo se serve, poi fai il parsing con BeautifulSoup.
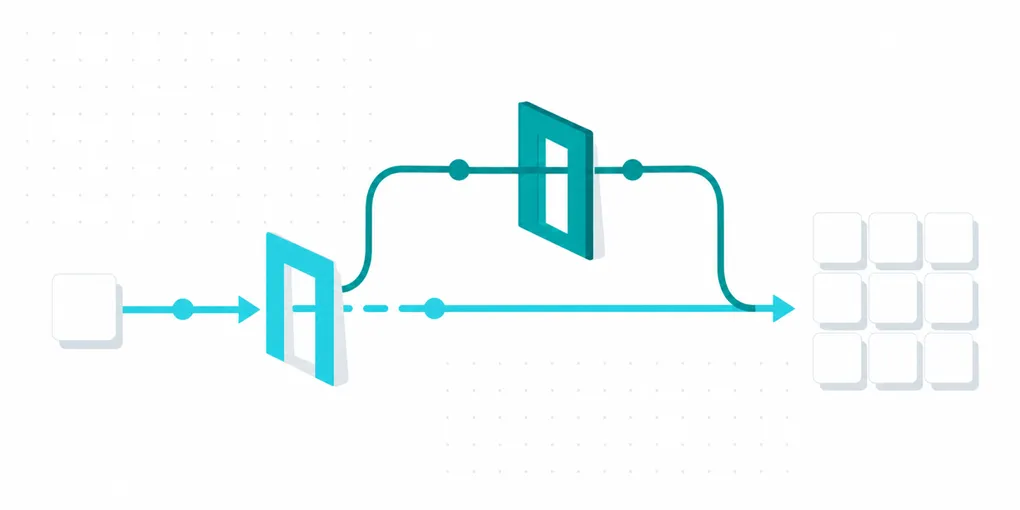
La maggior parte delle guide allo scraping è scritta per un target specifico: Google, Amazon, un marketplace particolare. Questa è per l’altro caso, un URL che non controlli e non hai mai scrapato prima, dove ti serve l’HTML in modo affidabile e poi devi capire da solo il parsing.
La richiesta base
Un endpoint, un parametro obbligatorio:
import requests

API_KEY = "faf_live_..."  # la tua chiave FastAF

resp = requests.get(
    "https://api.fastaf.co/v1/scrape",
    params={"url": "https://example.com/product/123"},
    headers={"Authorization": f"Bearer {API_KEY}"},
    timeout=60,
)
resp.raise_for_status()
html = resp.text
Il corpo della risposta è la pagina stessa, con il suo content type (HTML di default, markdown con formats=markdown), non un wrapper JSON.
Di default questo è un fetch statico, nessun browser, nessun rendering, instradato attraverso infrastruttura costruita per non farsi bloccare facendolo. È anche il livello più economico: 1 credito.
Quando ti serve più del default?
Sali di livello in ordine, solo per quanto il target lo richieda davvero:
- Statico, 1 credito. Parti sempre da qui. Funziona per pagine renderizzate server-side, la maggior parte dei blog, siti di documentazione, e qualunque pagina dove il contenuto che vuoi è nella risposta HTML iniziale.
dynamic=true, 5 crediti. La pagina costruisce il suo contenuto con JavaScript dopo il caricamento, comune con siti guidati da React/Vue/Svelte e liste a scorrimento infinito. Il nostro pezzo sul rendering JS copre esattamente come capire in quale caso sei prima di spendere i crediti extra.premium=true, 10 crediti. Il fetch statico viene bloccato o riceve una pagina degradata, non per JavaScript mancante ma per difese basate su IP. Premium instrada la richiesta attraverso infrastruttura proxy di qualità superiore.- Entrambi insieme, 25 crediti. Il target renderizza lato client e si difende aggressivamente contro gli IP automatizzati. Riserva questo livello ai siti dove hai confermato di aver bisogno di entrambi, non come impostazione di default “non si sa mai”.
def scrape(url, dynamic=False, premium=False, wait=None):
    params = {"url": url}
    if dynamic:
        params["dynamic"] = "true"
    if premium:
        params["premium"] = "true"
    if wait:
        params["wait"] = wait
    resp = requests.get(
        "https://api.fastaf.co/v1/scrape",
        params=params,
        headers={"Authorization": f"Bearer {API_KEY}"},
        timeout=90,
    )
    resp.raise_for_status()
    return resp.text
wait (millisecondi) conta soprattutto sulle richieste dynamic=true per le pagine che lanciano una chiamata API dopo il caricamento e renderizzano il risultato un momento dopo; senza, puoi ricevere lo stato di caricamento invece del contenuto.
Estrarre i tuoi dati
Questa è la parte che resta tua indipendentemente dal livello che usi. /scrape ti dà lo stesso HTML che un browser renderizzerebbe per quell’URL, in modo affidabile e senza farsi bloccare. Non sa che aspetto ha un “prezzo” o un “titolo prodotto” sul tuo target specifico, perché ogni sito marca quel contenuto in modo diverso. È un lavoro diverso da /serp, /maps o /amazon, dove conosciamo già la struttura della pagina e ti diamo campi già parsati; qui il fetch è risolto, il parsing tocca a te:
from bs4 import BeautifulSoup

html = scrape("https://example.com/product/123")
soup = BeautifulSoup(html, "html.parser")

title = soup.select_one("h1.product-title")
price = soup.select_one("span.price")

print(title.get_text(strip=True) if title else None)
print(price.get_text(strip=True) if price else None)
Scrivi i tuoi selettori contro il sito target allo stesso modo in cui li scriveresti contro HTML che hai fatto il fetch da solo. Se quel sito si rifà il design, i tuoi selettori si rompono, come per qualunque scraper; quello che hai tolto dal problema è farsi bloccare e aver bisogno di una farm di browser solo per fare il fetch della pagina.
Errori comuni
Usare dynamic=true di default per tutto. È un costo 5x rispetto a statico, e la maggior parte delle pagine non ne ha bisogno. Controlla prima con il metodo nel post sul rendering JS invece di pagare il sovrapprezzo di default.
Non impostare wait sulle pagine dinamiche lente a caricare. Se il contenuto si carica via una chiamata API ritardata, l’attesa di default potrebbe catturare la pagina prima che sia pronta. Se i campi tornano costantemente vuoti su dynamic=true, è la prima cosa da controllare.
Trattare ogni risposta diversa da 200 come uno scrape fallito. Un target che risponde 404 o 410 torna come HTTP 422 target_unavailable e non costa nulla. Un muro di login o una pagina d’errore “morbida” torna invece come un normale 200 con quella pagina nel body, quindi controlla html per vedere cosa è stato davvero restituito.
Fare il parsing prima di controllare che html non sia vuoto. Una risposta bloccata o vuota passata direttamente in BeautifulSoup fallisce dentro il parser invece che nel punto dove il problema reale è visibile. Controlla prima la risposta.
Selettori hardcoded senza fallback. Un singolo .select_one() che restituisce None su un redesign dovrebbe essere un segnale che controlli, non un’eccezione che uccide l’intero batch.
La versione breve
Parti statico, a 1 credito. Sali a dynamic=true solo quando hai confermato che il contenuto è renderizzato via JavaScript, a premium=true solo quando vieni bloccato a livello IP, ed entrambi solo quando un target ne ha davvero bisogno. Il fetch è la parte che FastAF risolve; fare il parsing del risultato con BeautifulSoup, selettori e gestione errori per il tuo target specifico resta la parte che scrivi tu.