Wie du 2026 jede Website mit Python scrapst
Ein allgemeiner /scrape-Workflow: statischer Fetch als Standard, Eskalation zu JS-Rendering und Premium-Proxys nur bei Bedarf, dann Parsing mit BeautifulSoup.
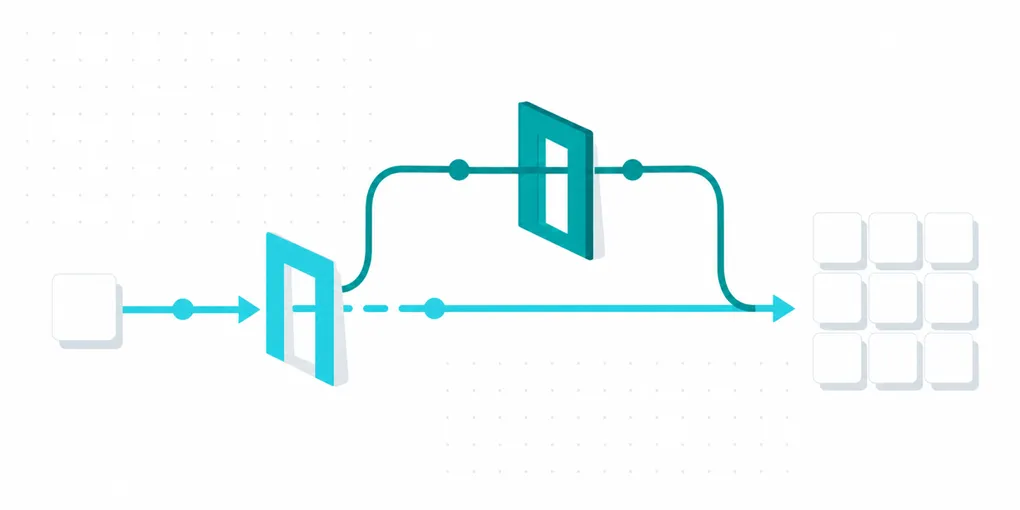
Die meisten Scraping-Guides sind für ein Ziel geschrieben: Google, Amazon, einen bestimmten Marktplatz. Dieser hier ist für den anderen Fall, eine URL, die du nicht kontrollierst und noch nie gescrapt hast, bei der du das HTML zuverlässig brauchst und das Parsing danach selbst herausfinden musst.
Die Basisanfrage
Ein Endpoint, ein Pflichtparameter:
import requests

API_KEY = "faf_live_..."  # dein FastAF-Key

resp = requests.get(
    "https://api.fastaf.co/v1/scrape",
    params={"url": "https://example.com/product/123"},
    headers={"Authorization": f"Bearer {API_KEY}"},
    timeout=60,
)
resp.raise_for_status()
html = resp.text
Der Antwort-Body ist die Seite selbst, mit ihrem Content-Type (standardmäßig HTML, Markdown mit formats=markdown), kein JSON-Wrapper.
Standardmäßig ist das ein statischer Fetch, kein Browser, kein Rendering, über Infrastruktur geroutet, die genau dafür gebaut ist, dabei nicht blockiert zu werden. Es ist außerdem die günstigste Stufe: 1 Credit.
Wann brauchst du mehr als den Standard?
Eskaliere der Reihe nach, nur so weit, wie das Ziel es wirklich verlangt:
- Statisch, 1 Credit. Fang hier immer an. Funktioniert für serverseitig gerenderte Seiten, die meisten Blogs, Docs-Seiten und jede Seite, bei der der gewünschte Inhalt schon in der initialen HTML-Antwort steckt.
dynamic=true, 5 Credits. Die Seite baut ihren Inhalt nach dem Laden per JavaScript, üblich bei React-/Vue-/Svelte-gesteuerten Seiten und Infinite-Scroll-Listings. Unser Beitrag zu JS-Rendering zeigt genau, wie du erkennst, welcher Fall vorliegt, bevor du die zusätzlichen Credits ausgibst.premium=true, 10 Credits. Der statische Fetch wird blockiert oder bekommt eine degradierte Seite, nicht wegen fehlendem JavaScript, sondern wegen IP-basierter Abwehr. Premium routet die Anfrage über hochwertigere Proxy-Infrastruktur.- Beides zusammen, 25 Credits. Das Ziel rendert clientseitig und verteidigt sich zusätzlich aggressiv gegen automatisierte IPs. Reserviere diese Stufe für Seiten, bei denen du bestätigt hast, dass du beides brauchst, nicht als Standardeinstellung “sicherheitshalber”.
def scrape(url, dynamic=False, premium=False, wait=None):
    params = {"url": url}
    if dynamic:
        params["dynamic"] = "true"
    if premium:
        params["premium"] = "true"
    if wait:
        params["wait"] = wait
    resp = requests.get(
        "https://api.fastaf.co/v1/scrape",
        params=params,
        headers={"Authorization": f"Bearer {API_KEY}"},
        timeout=90,
    )
    resp.raise_for_status()
    return resp.text
wait (in Millisekunden) ist vor allem bei dynamic=true-Anfragen für Seiten wichtig, die nach dem Laden einen API-Call feuern und das Ergebnis erst einen Moment später rendern; ohne wait bekommst du eventuell den Ladezustand statt den Inhalt.
Deine Daten extrahieren
Das ist der Teil, der egal bei welcher Stufe bei dir bleibt. /scrape besorgt dir dasselbe HTML, das ein Browser für diese URL rendern würde, zuverlässig und ohne blockiert zu werden. Es weiß nicht, wie ein “Preis” oder ein “Produkttitel” bei deinem konkreten Ziel aussieht, weil jede Seite das anders auszeichnet. Das ist ein anderer Job als bei /serp, /maps oder /amazon, wo wir die Seitenstruktur schon kennen und dir geparste Felder liefern; hier ist der Fetch gelöst, das Parsing liegt bei dir:
from bs4 import BeautifulSoup

html = scrape("https://example.com/product/123")
soup = BeautifulSoup(html, "html.parser")

title = soup.select_one("h1.product-title")
price = soup.select_one("span.price")

print(title.get_text(strip=True) if title else None)
print(price.get_text(strip=True) if price else None)
Schreib deine Selektoren gegen die Zielseite genauso, wie du es gegen selbst geholtes HTML tun würdest. Wenn diese Seite ein Redesign macht, brechen deine Selektoren, wie bei jedem Scraper; was du aus dem Problem herausgenommen hast, ist das Blockiertwerden und die Notwendigkeit einer Browser-Farm, nur um die Seite überhaupt zu holen.
Häufige Fehler
Standardmäßig dynamic=true für alles nutzen. Das kostet das 5-Fache gegenüber statisch, und die meisten Seiten brauchen es nicht. Prüfe zuerst mit der Methode aus dem JS-Rendering-Post, statt standardmäßig den Aufpreis zu zahlen.
wait bei langsam ladenden dynamischen Seiten nicht setzen. Wenn Inhalt über einen verzögerten API-Call lädt, kann die Standardwartezeit die Seite erfassen, bevor sie bereit ist. Wenn Felder bei dynamic=true konsequent leer zurückkommen, ist das der erste Punkt, den du prüfst.
Jede Antwort außer 200 als fehlgeschlagenen Scrape behandeln. Ein Ziel, das 404 oder 410 liefert, kommt als HTTP 422 target_unavailable zurück und kostet nichts. Eine Login-Wand oder eine “weiche” Fehlerseite kommt dagegen als normales 200 mit dieser Seite im Body, also prüfe html, um zu sehen, was tatsächlich zurückkam.
Parsen, bevor geprüft ist, dass html nicht leer ist. Eine blockierte oder leere Antwort, direkt in BeautifulSoup gegeben, schlägt im Parser fehl statt an der Stelle, wo das eigentliche Problem sichtbar wäre. Prüfe zuerst die Antwort.
Selektoren fest verdrahten, ohne Fallback. Ein einzelnes .select_one(), das bei einem Redesign None liefert, sollte ein Signal sein, das du abfängst, keine Exception, die den ganzen Batch killt.
Kurzversion
Fang statisch an, bei 1 Credit. Eskaliere zu dynamic=true nur, wenn du bestätigt hast, dass der Inhalt per JavaScript gerendert wird, zu premium=true nur, wenn du auf IP-Ebene blockiert wirst, und zu beidem nur, wenn ein Ziel es wirklich braucht. Der Fetch ist der Teil, den FastAF löst; das Ergebnis mit BeautifulSoup zu parsen, mit Selektoren und Fehlerbehandlung für dein konkretes Ziel, ist immer noch der Teil, den du selbst schreibst.