Cómo scrapear cualquier sitio web con Python en 2026
Flujo general con /scrape: fetch estático por defecto, escala a renderizado JS y proxies premium solo cuando haga falta, y analiza con BeautifulSoup.
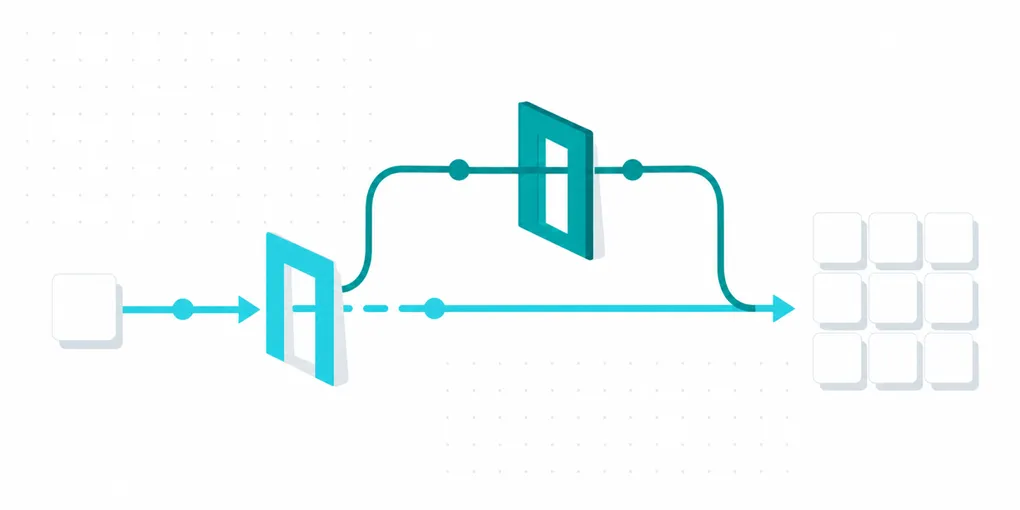
La mayoría de guías de scraping están escritas para un objetivo concreto: Google, Amazon, un marketplace específico. Esta es para el otro caso, una URL que no controlas y que no has scrapeado antes, donde necesitas el HTML de forma fiable y luego tienes que resolver tú mismo el parsing.
La solicitud básica
Un endpoint, un parámetro obligatorio:
import requests

API_KEY = "faf_live_..."  # tu clave de FastAF

resp = requests.get(
    "https://api.fastaf.co/v1/scrape",
    params={"url": "https://example.com/product/123"},
    headers={"Authorization": f"Bearer {API_KEY}"},
    timeout=60,
)
resp.raise_for_status()
html = resp.text
El cuerpo de la respuesta es la propia página, con su content type (HTML por defecto, markdown con formats=markdown), no un envoltorio JSON.
Por defecto esto es un fetch estático, sin navegador, sin renderizado, enrutado a través de una infraestructura construida para no bloquearse al hacerlo. Es también el nivel más barato: 1 crédito.
¿Cuándo necesitas más que lo básico?
Escala en orden, solo hasta donde el objetivo realmente lo exija:
- Estático, 1 crédito. Empieza siempre aquí. Funciona para páginas renderizadas en servidor, la mayoría de blogs, sitios de documentación, y cualquier página donde el contenido que buscas esté en la respuesta HTML inicial.
dynamic=true, 5 créditos. La página construye su contenido con JavaScript después de cargar, algo habitual en sitios basados en React/Vue/Svelte y listados con scroll infinito. Nuestro artículo sobre renderizado JS explica exactamente cómo saber en qué caso estás antes de gastar los créditos extra.premium=true, 10 créditos. El fetch estático está siendo bloqueado o recibe una página degradada, no por falta de JavaScript sino por defensas basadas en IP. Premium enruta la solicitud a través de una infraestructura de proxies de mayor calidad.- Ambos juntos, 25 créditos. El objetivo renderiza en el cliente y además se defiende agresivamente contra IPs automatizadas. Reserva este nivel para sitios donde has confirmado que necesitas ambos, no como ajuste por defecto “por si acaso”.
def scrape(url, dynamic=False, premium=False, wait=None):
    params = {"url": url}
    if dynamic:
        params["dynamic"] = "true"
    if premium:
        params["premium"] = "true"
    if wait:
        params["wait"] = wait
    resp = requests.get(
        "https://api.fastaf.co/v1/scrape",
        params=params,
        headers={"Authorization": f"Bearer {API_KEY}"},
        timeout=90,
    )
    resp.raise_for_status()
    return resp.text
wait (en milisegundos) importa sobre todo en solicitudes con dynamic=true para páginas que disparan una llamada a una API tras la carga y renderizan el resultado un instante después; sin él puedes obtener el estado de carga en lugar del contenido.
Extraer tus datos
Esta es la parte que sigue siendo tuya sin importar qué nivel uses. /scrape te da el mismo HTML que renderizaría un navegador para esa URL, de forma fiable y sin bloqueos. No sabe qué aspecto tiene un “precio” o un “título de producto” en tu objetivo concreto, porque cada sitio lo marca de forma distinta. Eso es un trabajo diferente al de /serp, /maps o /amazon, donde ya conocemos la estructura de la página y te entregamos campos analizados; aquí, el fetch está resuelto, el parsing es cosa tuya:
from bs4 import BeautifulSoup

html = scrape("https://example.com/product/123")
soup = BeautifulSoup(html, "html.parser")

title = soup.select_one("h1.product-title")
price = soup.select_one("span.price")

print(title.get_text(strip=True) if title else None)
print(price.get_text(strip=True) if price else None)
Escribe tus selectores contra el sitio objetivo igual que lo harías contra un HTML que hubieras obtenido tú mismo. Si ese sitio se rediseña, tus selectores se rompen, igual que en cualquier scraper; lo que has eliminado del problema es que te bloqueen y tener que montar una granja de navegadores solo para obtener la página.
Errores comunes
Usar dynamic=true por defecto para todo. Cuesta 5 veces más créditos que el estático, y la mayoría de páginas no lo necesitan. Compruébalo primero con el método del post sobre renderizado JS en lugar de pagar el extra por defecto.
No configurar wait en páginas dinámicas lentas. Si el contenido carga mediante una llamada a una API retardada, la espera por defecto puede capturar la página antes de que esté lista. Si los campos vuelven vacíos de forma constante con dynamic=true, esto es lo primero que hay que revisar.
Tratar cualquier respuesta distinta de 200 como un scrape fallido. Un objetivo que responde 404 o 410 vuelve como HTTP 422 target_unavailable y no cuesta nada. Un muro de login o una página de error “suave” vuelve como un 200 normal con esa página en el body, así que revisa html para ver qué se devolvió realmente.
Analizar antes de comprobar que html no está vacío. Una respuesta bloqueada o vacía pasada directamente a BeautifulSoup falla dentro del parser en lugar de en el punto donde el problema real es visible. Comprueba primero la respuesta.
Hardcodear selectores sin fallback. Un único .select_one() que devuelve None tras un rediseño debería ser una señal que compruebas, no una excepción que mata todo el lote.
En resumen
Empieza en estático, a 1 crédito. Escala a dynamic=true solo cuando hayas confirmado que el contenido se renderiza con JavaScript, a premium=true solo cuando te estén bloqueando a nivel de IP, y a ambos solo cuando un objetivo lo necesite de verdad. El fetch es la parte que resuelve FastAF; analizar el resultado con BeautifulSoup, selectores y manejo de errores para tu objetivo concreto sigue siendo la parte que escribes tú.