Blog
Blog
Benchmarks que rodamos, coisas que quebraram, e como raspar sem ser babá de proxy.
Como um agente de IA paga cada busca na web com x402
Sem conta e sem chave de API: o desafio 402 real que o FastAF devolve, o cliente Node que paga em USDC na Base e como limitar o que o agente gasta por chamada.
Amazon PA-API aposentada: como obter dados de produtos sem ela
A PA-API 5 agora responde 403 e aponta para a Creators API. Quem deve migrar, quem precisa de uma API de dados, mapeamento de campos e cobertura real.
Comparar preços Amazon na UE: diferença de 19% entre lojas
Medimos 80 produtos na amazon.de, .fr, .it, .es e .nl em 19 de outubro de 2026: diferença mediana de 19%, sem uma loja sempre mais barata. Método, tabelas e Python para monitoramento de preços.
Como criar um MCP server em Python para uma API de dados web
Um MCP server funcional em 109 linhas de Python: três tools de dados web, erros que dizem ao agente o que fazer e orçamento de créditos por sessão. Testado em 19/10/2026.
Crie um agente de pesquisa na web com o Claude Agent SDK e um orçamento rígido
Cerca de 60 linhas de Python: Claude Agent SDK mais o servidor MCP do FastAF para busca, leitura de páginas e Google Scholar. Uma execução real custou 11 créditos.
Web scraping é legal na UE? GDPR, LGPD e raspagem de dados
Web scraping é crime? O que a lei da UE diz sobre raspagem de dados em páginas públicas: GDPR e interesse legítimo, direito sui generis, mineração de dados, AI Act e checklist.
Google Search no LangChain depois do fim do Custom Search
Troque o GoogleSearchAPIWrapper antes de 1º de janeiro de 2027: uma tool do LangChain testada que mantém title, link e snippet. Alternativa ao Custom Search.
Busca web nativa do LLM vs SERP API: custo por resposta
Claude e OpenAI cobram $10 por 1.000 buscas mais os tokens do resultado. Medimos o lado dos tokens em 20 perguntas e calculamos 1.000 respostas nos dois modelos.
Busca na web no Claude Code, no Cursor e no Codex com um único servidor MCP
Um servidor MCP remoto dá a um agente de programação 15 ferramentas: busca na web, páginas em markdown, mapas, Amazon, transcrições do YouTube. Setup para três clientes, testado.
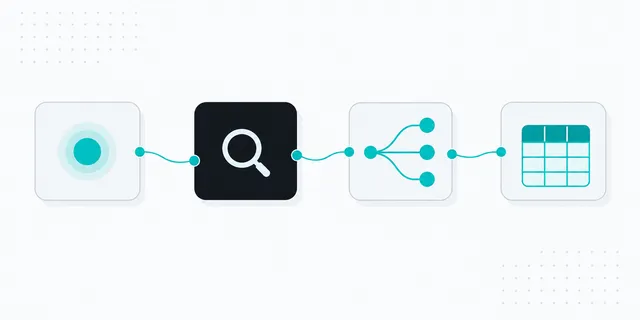
n8n web scraping: raspagem de dados e busca no Google sem código
Importe um workflow do n8n que percorre uma lista de palavras-chave, chama uma API de busca do Google, raspa as páginas do topo em markdown e grava linhas no Google Sheets ou em um CSV.
Playwright MCP: custo em tokens vs ler a página em markdown
Rodamos o servidor Playwright MCP real e o markdown do FastAF em 11 páginas públicas e contamos tokens. Página mediana: 9.874 vs 5.083, com exceções nos dois sentidos.
Meça a visibilidade da sua marca em respostas de IA com Python
Rodamos 45 prompts no Google AI Mode três vezes cada. Em 43 de 45, as marcas citadas mudaram entre execuções idênticas. Monitoramento de marca: método, números e script.
Monitore o Google AI Overviews com Python: presença e fontes
Checamos 100 consultas do Google em 19/10/2026: quem recebe um AI Overview, o que ele cita, quão estável é, e um tracker em Python que guarda snapshots.
Busca na web para agentes de IA depois do Bing: que opções sobraram em 2026?
As Bing Search APIs foram aposentadas em agosto de 2025 e o Google Custom Search está fechado para novos clientes. Restam quatro tipos de backend de busca para agentes.
Por que a ferramenta de fetch do seu agente de IA volta com uma página vazia
Shell vazio, muro de cookies, redirecionamento para login ou página cortada: como diferenciar cada caso em 30 linhas de Python, com medições reais de 19 de outubro de 2026.
Como conseguir a resposta do AI Mode do Google e suas fontes via API
A resposta composta e as páginas que ela cita, como JSON, e por que o texto é saída do Google Search AI Mode que pode mudar entre duas chamadas idênticas. Testado em agosto de 2026.
Extraindo artigos, autores e contagens de citação do Google Scholar com Python
Busque um tópico no Google Scholar e receba artigos, anos e contagens de citação como JSON, construído em torno de um endpoint lento o bastante para precisar rodar como job em lote. Testado em agosto de 2026.
Compare preços de produtos entre lojas com a API do Google Shopping
Faça o parsing da string de preço você mesmo, descarte as partes do payload que você não precisa, e use uma busca específica o bastante para conseguir ofertas comparáveis. Testado em agosto de 2026.
Transforme o Google Trends em um sinal de demanda com Python
Leia a série temporal, calcule uma direção de tendência simples, e a única coisa que precisa acertar: um valor do Trends é interesse relativo, nunca um número de volume de busca. Testado em agosto de 2026.
Como extrair vagas do Google Jobs com Python
Empresa, localização e links para se candidatar do Google Jobs como JSON, e o formato de resposta que quebra código de parsing ingênuo em um HTTP 200 comum. Testado em agosto de 2026.
Monitore menções à marca e à concorrência com a API do Google News
Consulte um conjunto de termos de busca em um cronograma, elimine duplicados pelo link do artigo, e veja só o que mudou desde a última execução. Testado com uma resposta real em agosto de 2026.
Monitore preços da Walmart para um conjunto de produtos com Python
Monte uma URL de busca da Walmart, percorra os grupos e itens aninhados na resposta, e combine com o endpoint da Amazon para comparar um preço entre as duas. Testado em agosto de 2026.
Automatize screenshots de sites com Python para monitoramento
Capture uma página como PNG com uma requisição, grave os bytes direto num arquivo, e decida com base no content-type em vez de adivinhar quando uma captura falha. Testado em agosto de 2026.
Obtenha dados públicos de perfil do X com Python para enriquecimento de leads
Consulte número de seguidores, bio e verificação de um perfil público do X com uma requisição e sem conta de desenvolvedor, mais exatamente o que o endpoint não cobre. Testado em agosto de 2026.
Concorrência, não créditos, decide quanto tempo seu job de scraping leva
O mesmo job de 200.000 requisições leva 22h com 5 slots, 4,4h com 25. Por que os planos limitam a concorrência, e um worker pool correto em Python.
Quanto custa fazer scraping de 1 milhão de páginas em 2026?
Proxies caseiros, compute e tempo de engenharia contra $299 fixos por 1.000.000 de créditos: o custo real de scraping de 1 milhão de páginas, agosto de 2026.
Planos gratuitos de API de SERP comparados (2026)
SerpApi dá 250 buscas/mês, Serper dá 2.500 de uma vez, FastAF dá 500 créditos (100 buscas) de uma vez. Verificado nas páginas de preços, ago 2026.
Geração de leads no Google Maps: um manual prático
Uma categoria e uma lista de cidades viram um CSV de leads filtrado e enriquecido. Loop completo em Python e o custo de uma campanha de 100 cidades.
Como obter resultados de busca do Google em JSON (sem parsing de HTML)
O Google serve markup ofuscado e rotativo. Aqui está o contrato JSON do /serp: campos garantidos, blocos opcionais, testado em agosto de 2026.
A API de busca oficial do Google contra as APIs de SERP: quais são suas opções em 2026?
A Custom Search JSON API dá 100 consultas grátis por dia e $5 por 1.000, teto de 10 mil/dia, e está fechada para novos cadastros desde agosto de 2026.
Como monitorar rankings de keywords com Python
Um rank tracker mínimo em Python: consulta, extrai a posição de organic_results, guarda no SQLite, e a matemática de créditos por trás da profundidade.
Fazer scraping do LinkedIn é legal em 2026?
hiQ contra LinkedIn definiu o critério do CFAA para dados públicos, mas em fev/2026 o LinkedIn fechou acordo em outra ação de scraping.
Rendering JavaScript em web scraping: quando você precisa e quanto custa
Como saber se uma página precisa de um navegador de verdade, por que o rendering custa mais em todo lugar, e os multiplicadores de crédito, agosto de 2026.
Crie um bot de monitoramento de preços em Python (Amazon + Google Shopping)
Descubra produtos, monitore ASINs por preço, salve o histórico no SQLite e receba alertas de queda. Bot completo com o custo real em créditos.
requests + BeautifulSoup vs. uma scraping API: quando o DIY é suficiente
Para sites estáticos sem anti-bot, requests e BeautifulSoup não custam nada e funcionam bem. Aqui está exatamente onde isso deixa de ser verdade.
Como extrair dados de produtos da Amazon sem ser bloqueado
Resultados de busca, preços, avaliações e ASINs da Amazon em JSON: por que o DIY falha rápido, quanto custam os dados e um exemplo testado em Python.
Como fazer scraping de qualquer site com Python em 2026
Um fluxo com /scrape: busca estática por padrão, escalando para renderização JS e proxies premium só quando necessário, depois parsing com BeautifulSoup.
Como extrair resultados do Google Maps com Python
Locais, avaliações, reviews e contatos do Google Maps em JSON, por que a Places API oficial fica cara, e quanto custa de verdade uma busca no Maps.
Fazer scraping do Google Search sem ser bloqueado: o que realmente acontece
Rate limits, muros de CAPTCHA, fingerprinting e a matemática da paginação: por que o scraping bruto do Google quebra, e por que só proxies não bastam.
Como obter transcrições do YouTube com Python (sem cotas de API)
A YouTube Data API não cobre transcrições, e o youtube-transcript-api tem o IP bloqueado na nuvem. Uma configuração que custa 1 crédito por vídeo.
Dando dados frescos da web para um LLM: SERP APIs para RAG e grounding
Uma pipeline mínima em Python para fundamentar um LLM em busca ao vivo, e por que um custo fixo em créditos vale mais que uma conta imprevisível.
Dê a um agente de IA busca na web ao vivo com um teto de gastos rígido
Um agente que busca na web pode entrar em loop. Veja como plugar a busca ao vivo para que o orçamento seja imposto pela API, não pela esperança.
Quanto custa de verdade uma SERP API por 1.000 buscas
Créditos, escalões de plano e paginação tornam difícil comparar preços de APIs de busca. Veja como calcular seu custo real por 1.000 buscas.
Como extrair resultados de busca do Google em Python
Por que requests + BeautifulSoup para de funcionar no Google, e uma configuração em Python que retorna SERP em JSON com paginação e tratamento de erros.