Google-Suchergebnisse als JSON bekommen (ohne HTML-Parsing)
Google liefert verschleiertes, rotierendes Markup. Hier ist stattdessen der /serp-JSON-Vertrag: garantierte Felder, optionale Blöcke, getestet im August 2026.
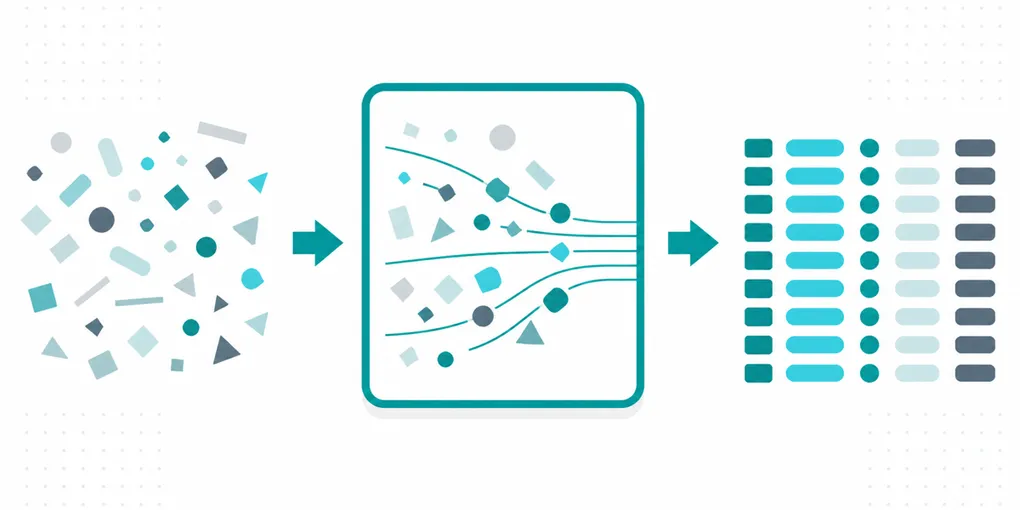
Es gibt zwei Wege, Daten aus einer Google-Ergebnisseite zu bekommen: das HTML parsen oder das JSON anfragen, das dieselbe Seite beschreibt. Nur einer der beiden übersteht ein Markup-Update.
Warum HTML-Parsing nicht standhält
Öffne den View-Source einer Ergebnisseite und such nach einem Klassennamen, auf den du einen CSS-Selektor bauen möchtest. Du wirst keinen finden, der wie result-title klingt. Du findest etwas wie MjjYud oder g6HRUb, maschinengeneriert und anders als der String, den du letzte Woche gesehen hast. Googles Frontend wird pro Build kompiliert und verschleiert, und der Build rotiert.
Selbst wenn du einen Selektor auf etwas Stabiles pinnst, wie ein href-Muster, ändert sich das Layout darunter je nach Abfragetyp. Eine einfache Informationsabfrage rendert anders als eine, die ein Knowledge Panel, einen Local Pack oder ein Shopping-Karussell auslöst. Am Ende schreibst du einen Parser pro Abfrageform, und schreibst sie alle neu, sobald Google das nächste Redesign ausliefert.
Das ist auch kein google-spezifisches Problem: JavaScript rendert oft Teile der Seite erst nach dem Laden, sodass ein einfacher requests.get-Aufruf mit BeautifulSoup-Durchlauf Inhalte verpassen kann, die ein echter Browser zeigen würde. Das ist ein eigener Kostenpunkt, behandelt in unserem Beitrag darüber, wann Scraping JS-Rendering braucht.
Wie eine JSON-Antwort tatsächlich aussieht
Schick dieselbe Abfrage an eine API, die das geparste Ergebnis statt der Seite zurückgibt, und du bekommst eine feste Menge an Keys statt ein DOM zum Durchlaufen:
import requests

API_KEY = "faf_live_..."  # dein FastAF-Key

resp = requests.get(
    "https://api.fastaf.co/v1/serp",
    params={
        "query": "best noise cancelling headphones",
        "country": "us",
        "language": "en",
        "device": "mobile",
    },
    headers={"Authorization": f"Bearer {API_KEY}"},
    timeout=60,
)
resp.raise_for_status()
data = resp.json()

for result in data["organic_results"]:
    print(result["rank"], result["title"], result["link"], result["snippet"][:60])
Die Felder, auf die du dich verlassen kannst
organic_results ist der eine Teil der Antwort, den du ohne Wenn und Aber bauen kannst: es ist eine Liste, und jeder Eintrag trägt rank, title, link und snippet. Das ist der Vertrag, unabhängig von der Abfrage.
| Feld | Was es ist |
|---|---|
rank |
Rang auf der Seite, 1-indexiert |
title |
Der blaue Linktext |
link |
Die Ziel-URL |
snippet |
Der Beschreibungstext unter dem Ergebnis |
Alles andere in der Antwort hängt davon ab, was die Abfrage tatsächlich erzeugt, genauso wie es von der Live-Seite abhängt. Blöcke wie people_also_ask, ein Knowledge Panel, Anzeigen oder verwandte Suchanfragen tauchen als zusätzliche Top-Level-Keys auf, wenn Google sie für diese Abfrage rendert, und fehlen sonst einfach. Schreib Code, der den Key prüft, bevor er ihn liest (data.get("people_also_ask")), keinen Code, der annimmt, er wäre immer da.
Die Parameter, die den Request formen
Die vollständige Parameterliste steht in den Docs, aber die, die du bei fast jedem Request brauchst:
q(Aliasquery): der Suchbegriff.country: zweistelliger Ländercode, von dem aus gesucht wird, ändert, welche Google-Domain und welchen Ergebnissatz du bekommst.language(Aliaslang): Sprache von Interface und Ergebnissen.device:mobileoderdesktop. Rankings und Layout unterscheiden sich zwischen beiden, und mobile ist für die meisten Branchen der Großteil des echten Traffics, also zieh beide, wenn dir die Rangposition wichtig ist.page: für Tiefe über die erste Seite hinaus.location: ein präziseres geografisches Signal alscountryallein, nützlich bei Abfragen mit lokaler Absicht.safe: SafeSearch an oder aus.tbs: Googles eigener Zeit- und Filterparameter, für datumsbeschränkte Suchen.
device zwischen Requests zu wechseln ist der günstigste Weg, um einen Ranking-Unterschied zu erwischen, den ein reines Desktop-Setup komplett verpassen würde:
for device in ["desktop", "mobile"]:
    r = requests.get(
        "https://api.fastaf.co/v1/serp",
        params={"query": "project management software", "country": "us", "device": device},
        headers={"Authorization": f"Bearer {API_KEY}"},
        timeout=60,
    )
    top = r.json()["organic_results"][0]
    print(device, "->", top["rank"], top["link"])
Was es kostet
Ein /serp-Request kostet 5 Credits, unabhängig davon, wie viele Blöcke die Abfrage erzeugt. Wir haben beim Schreiben dieses Beitrags (August 2026) einen Request abgesetzt, der für diese 5 Credits 10 organische Ergebnisse zurückgab. Google akzeptiert num=100 nicht mehr, wenn du also die Top 100 Ergebnisse für ein Keyword brauchst, plan mit 10 paginierten Requests, nicht mit einem; die Aufschlüsselung der Kosten pro 1.000 Suchen geht durch, was das mit deiner Rechnung macht.
Fehlgeschlagene Requests werden nicht abgerechnet: Credits werden reserviert, wenn der Request startet, und zurückgegeben, wenn nichts zurückkommt.
Kurz zusammengefasst
organic_results mit rank, title, link und snippet ist der Teil des Vertrags, auf den du dich immer verlassen kannst. Alles andere in der Antwort, people_also_ask eingeschlossen, ist da, wenn Google es rendert, und fehlt, wenn nicht, also gate deinen Code auf den Key, nicht auf die Abfrage. Vollständige Referenz in den Docs, oder starte mit dem kostenlosen Kontingent, 500 Credits, keine Karte.