Comment obtenir les résultats de recherche Google en JSON (sans parsing HTML)
Google sert un balisage obfusqué et changeant. Voici le contrat JSON de /serp à la place : champs garantis, blocs optionnels, testé en août 2026.
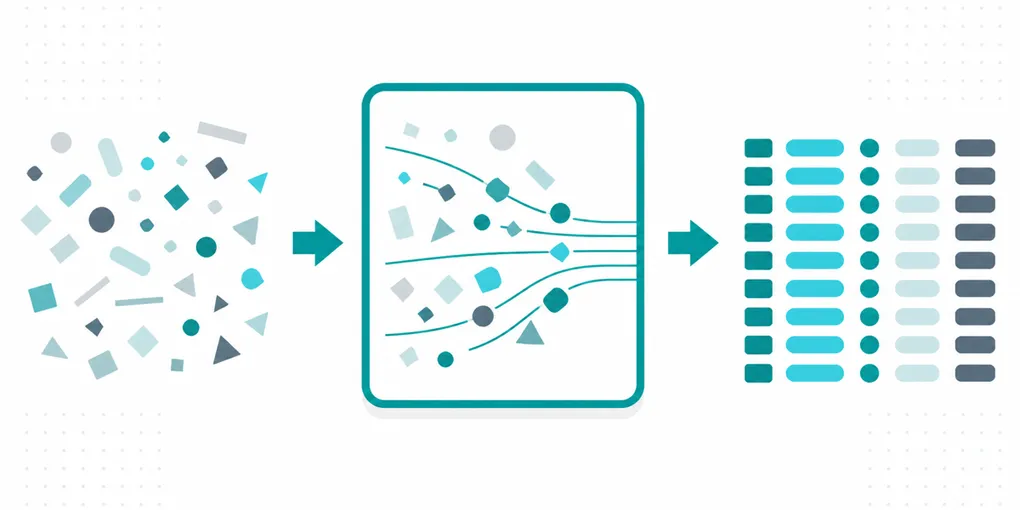
Il y a deux façons d’extraire des données d’une page de résultats Google : parser le HTML, ou demander le JSON qui décrit la même page. Une seule des deux survit à une mise à jour du balisage.
Pourquoi parser le HTML ne tient pas la route
Ouvrez le view-source d’une page de résultats et cherchez un nom de classe sur lequel vous voudriez construire un sélecteur CSS. Vous n’en trouverez pas qui se lise comme result-title. Vous trouverez quelque chose comme MjjYud ou g6HRUb, généré par machine, et différent de la chaîne que vous avez vue la semaine dernière. Le front-end de Google est compilé et obfusqué par build, et le build change régulièrement.
Même si vous ancrez un sélecteur sur quelque chose de stable, comme un motif d’href, la mise en page en dessous change selon le type de requête. Une requête informationnelle simple s’affiche différemment d’une requête qui déclenche un knowledge panel, un pack local, ou un carrousel shopping. Vous finissez par écrire un parser par forme de requête, puis à tous les réécrire la fois suivante où Google déploie une refonte.
Rien de tout cela n’est spécifique à Google, d’ailleurs : le JavaScript rend souvent des parties de la page après le chargement, donc un simple requests.get suivi d’un passage BeautifulSoup peut manquer du contenu qu’un vrai navigateur afficherait. C’est un coût distinct, couvert dans notre article sur les cas où le scraping a besoin du rendu JS.
À quoi ressemble réellement une réponse JSON
Envoyez la même requête à une API qui renvoie le résultat parsé au lieu de la page, et vous obtenez un ensemble fixe de clés au lieu d’un DOM à parcourir :
import requests

API_KEY = "faf_live_..."  # votre clé FastAF

resp = requests.get(
    "https://api.fastaf.co/v1/serp",
    params={
        "query": "best noise cancelling headphones",
        "country": "us",
        "language": "en",
        "device": "mobile",
    },
    headers={"Authorization": f"Bearer {API_KEY}"},
    timeout=60,
)
resp.raise_for_status()
data = resp.json()

for result in data["organic_results"]:
    print(result["rank"], result["title"], result["link"], result["snippet"][:60])
Les champs sur lesquels vous pouvez compter
organic_results est la seule partie de la réponse sur laquelle vous pouvez construire sans réserve : c’est une liste, et chaque entrée porte rank, title, link et snippet. C’est le contrat, quelle que soit la requête.
| Champ | Ce que c’est |
|---|---|
rank |
Rang sur la page, indexé à partir de 1 |
title |
Le texte du lien bleu |
link |
L’URL de destination |
snippet |
Le texte de description sous le résultat |
Tout le reste de la réponse est conditionnel à ce que la requête produit réellement, de la même façon que c’est conditionnel à la page en direct. Des blocs comme people_also_ask, un knowledge panel, des annonces ou des recherches associées apparaissent comme des clés supplémentaires de premier niveau quand Google les rend pour cette requête, et sont simplement absents sinon. Écrivez du code qui vérifie la présence de la clé avant de la lire (data.get("people_also_ask")), pas du code qui suppose qu’elle est toujours là.
Les paramètres qui façonnent la requête
La liste complète des paramètres est dans la documentation, mais ceux que vous utiliserez sur presque chaque requête :
q(aliasquery) : le terme de recherche.country: pays sur deux lettres depuis lequel chercher, change le domaine Google et le jeu de résultats obtenus.language(aliaslang) : langue de l’interface et des résultats.device:mobileoudesktop. Le classement et la mise en page diffèrent entre les deux, et le mobile représente la majorité du trafic réel pour la plupart des secteurs, donc récupérez les deux si la position de classement compte pour vous.page: pour aller au-delà de la première page.location: un signal géographique plus précis quecountryseul, utile pour les requêtes à intention locale.safe: SafeSearch activé ou désactivé.tbs: le paramètre de date et de filtre propre à Google, pour les recherches restreintes dans le temps.
Alterner device entre les requêtes est le moyen le moins cher de repérer une différence de classement qu’une configuration desktop uniquement raterait complètement :
for device in ["desktop", "mobile"]:
    r = requests.get(
        "https://api.fastaf.co/v1/serp",
        params={"query": "project management software", "country": "us", "device": device},
        headers={"Authorization": f"Bearer {API_KEY}"},
        timeout=60,
    )
    top = r.json()["organic_results"][0]
    print(device, "->", top["rank"], top["link"])
Ce que ça coûte
Une requête /serp coûte 5 crédits, quel que soit le nombre de blocs que produit la requête. Nous avons lancé une requête en écrivant cet article (août 2026) et elle a renvoyé 10 résultats organiques pour ces 5 crédits. Google n’honore plus num=100, donc si vous avez besoin des 100 premiers résultats pour un mot-clé, prévoyez 10 requêtes paginées, pas une seule ; le détail du coût pour 1 000 recherches explique ce que ça donne sur votre facture.
Les requêtes échouées ne sont pas facturées : les crédits sont réservés au démarrage de la requête et rendus si rien ne revient.
En bref
organic_results avec rank, title, link et snippet est la partie du contrat sur laquelle vous pouvez toujours compter. Tout le reste de la réponse, people_also_ask compris, est présent quand Google le rend et absent sinon, donc conditionnez votre code sur la clé, pas sur la requête. Référence complète dans la documentation, ou commencez avec l’offre gratuite, 500 crédits, sans carte.